
היגיינת דאטה: התנאי המוקדם להצלחת AI
AI טוב בדיוק כמו הנתונים שמזינים לו. לפני פרויקט AI צריך למפות את מקורות הנתונים, למנות לכל אחד בעלים, להגדיר את השדות המרכזיים, לנקות כפילויות ולמנוע מהבלגן לחזור. לא צריך נתונים מושלמים, אלא נתונים מסודרים לתהליך הספציפי שרוצים לשפר.
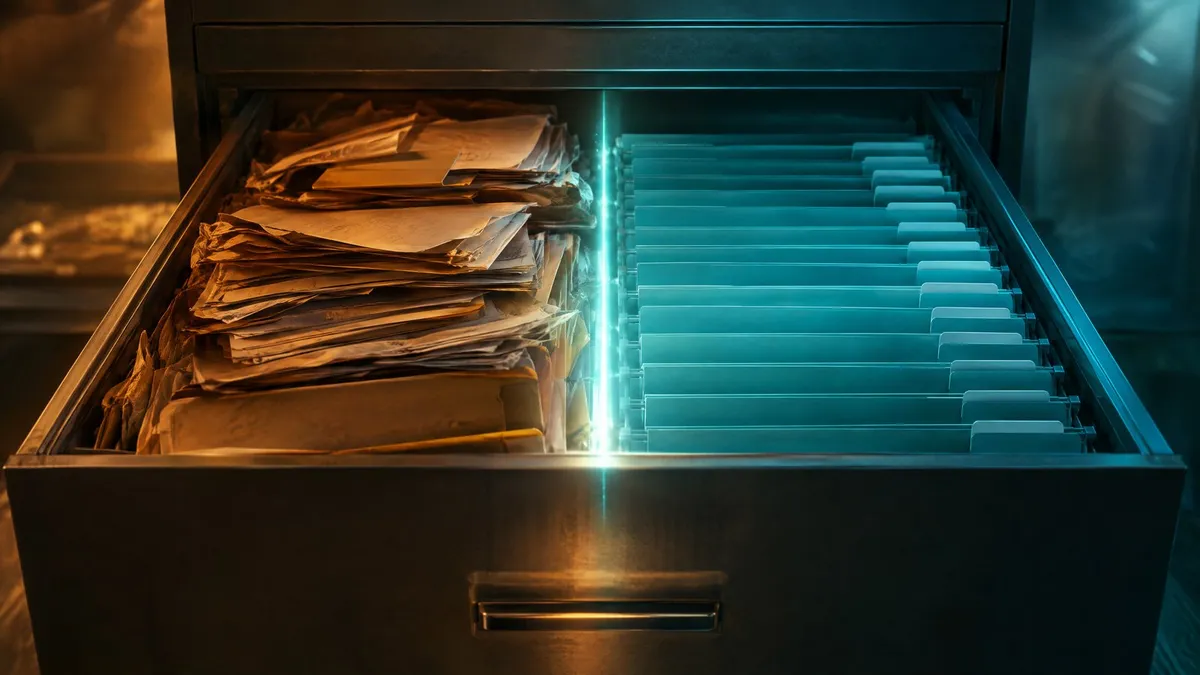
רוב בעלי העסקים מגיעים לשיחה על AI עם רעיון ברור: סוכן שעונה ללקוחות, דוח שנבנה לבד, תחזית מכירות שמתעדכנת כל בוקר. מה שפחות מדברים עליו הוא החומר שממנו כל זה אמור להיבנות: הנתונים שכבר יושבים אצלכם ב-CRM, בגיליונות האקסל, בתוכנת הנהלת החשבונות ובתיבות המייל.
אם אותו לקוח מופיע שלוש פעמים במערכת, אם השדה “סטטוס” אומר דבר אחר לכל איש מכירות, ואם אף אחד לא יודע מי אחראי לעדכן את מחירון הספקים, שום מודל לא יתקן את זה. הוא פשוט יעבוד מהר יותר על מידע שגוי. אי אפשר לעשות אוטומציה לכאוס.
המדריך הזה מסביר מה זו היגיינת דאטה, למה היא קודמת לכל פרויקט AI, ואיך עסק קטן או בינוני יכול לבדוק בעצמו אם הנתונים שלו מוכנים, עם רשימת בדיקה מעשית.
מה זה בעצם היגיינת דאטה?
היגיינת דאטה היא ההרגלים והכללים שמבטיחים שהנתונים בעסק מדויקים, עדכניים, אחידים, ושיש מי שאחראי עליהם. זה לא פרויקט ניקוי חד-פעמי אלא שגרה, בדיוק כמו הנהלת חשבונות מסודרת.
בפועל היא נשענת על כמה עקרונות פשוטים:
- דיוק: הפרטים נכונים. הטלפון של לקוח הוא הטלפון שלו, ולא של מי שהתקשר בשמו לפני שנתיים.
- אחידות: אותו מידע נרשם באותה צורה. “ת”א”, “תל אביב” ו-“Tel Aviv” הם שלושה ערכים שונים בעיני מחשב.
- שלמות: השדות החשובים באמת מולאו.
- עדכניות: המידע משקף את המצב היום, לא את המצב ברבעון שעבר.
- אחריות: לכל מקור נתונים יש בעלים שיודע מה יש בו ומחליט מה משנים.
- עקיבות: אפשר לדעת מי שינה מה ומתי.
ההבדל בין עסק עם היגיינת דאטה לעסק בלי הוא לא כמות המידע, אלא האם אפשר לסמוך עליו בלי לבדוק אותו ידנית בכל פעם.
למה AI תלוי כל כך באיכות הנתונים?
כי מערכות AI לא “מבינות” את העסק שלכם. הן לומדות ופועלות מתוך הנתונים שאתם נותנים להן, ונתונים שגויים מייצרים תשובות שגויות, בביטחון מלא ובקצב גבוה.
נניח שלושה מצבים נפוצים:
- סוכן שירות שמחובר ל-CRM ומשיב ללקוחות על סטטוס הזמנה. אם יש שתי רשומות לאותו לקוח, הוא עלול לשלוף את הישנה ולמסור מידע לא נכון.
- מודל לחיזוי מכירות שמתבסס על היסטוריית עסקאות. אם אנשי המכירות מעדכנים עסקאות רק בסוף החודש, או משאירים עסקאות מתות פתוחות, התחזית תהיה אופטימית מדי באופן קבוע.
- מודל שפה (LLM) שעונה על שאלות מתוך מסמכי החברה. אם בתיקייה יושבות שלוש גרסאות של נוהל ההחזרות, אין לו דרך לדעת איזו מהן בתוקף.
בכל המקרים האלה הבעיה איננה המודל. זו גם אחת הסיבות לכך שפרויקטי AI רבים נתקעים אחרי שלב הפיילוט: בהדגמה עובדים על נתונים נקיים שהוכנו מראש, ובשטח פוגשים את המציאות.
יש גם עלות ישירה. כשהנתונים לא מסודרים, חלק גדול מתקציב הפרויקט הולך על ניקוי ידני וסקריפטים חד-פעמיים, במקום על בניית היכולת שבשבילה התחלתם.
אילו בעיות נתונים הכי נפוצות בעסקים קטנים?
ברוב העסקים הקטנים והבינוניים חוזרות אותן בעיות: כפילויות, שדות טקסט חופשי, מידע שמפוזר בין מערכות, ונתונים שאין להם בעלים. הן נוצרות לאט ובלי כוונה רעה, ולכן קל לא לשים לב אליהן.
כפילויות
לקוח נרשם פעם דרך טופס באתר, פעם ידנית על ידי המזכירה, ופעם דרך ייבוא מאקסל. התוצאה היא שלוש רשומות, היסטוריה מפוצלת, ולפעמים שני אנשי מכירות שמתקשרים לאותו אדם באותו שבוע.
שדות חופשיים במקום רשימות סגורות
כשהשדה “מקור ליד” הוא טקסט חופשי, תקבלו “פייסבוק”, “FB”, “פייסבוק ממומן” ו“מאינסטגרם”. אי אפשר לנתח את זה בלי ניקוי ידני, ומודל שינסה ללמוד מזה יקבל תמונה מעוותת.
מידע שחי בכמה מקומות
מחיר מוצר מופיע במערכת ההזמנות, באקסל של מנהל המכירות ובהצעת מחיר ישנה ב-Word. כשמשנים מחיר, מעדכנים רק חלק מהמקומות, ואף אחד כבר לא בטוח מה המחיר הנכון.
נתונים בלי בעלים
אף אחד לא אחראי על רשימת הספקים, אז כולם מוסיפים ואף אחד לא מוחק. אחרי כמה שנים הרשימה מלאה בספקים שהעסק כבר לא עובד איתם.
איך מתחילים לסדר את הנתונים לפני פרויקט AI?
מתחילים במיפוי, לא בכלים. קודם מבינים אילו נתונים קיימים, איפה הם יושבים ומי משתמש בהם, ורק אחר כך מחליטים מה לנקות ומה לאחד.
- ממפים את מקורות הנתונים. רשימה פשוטה: כל מערכת וכל גיליון חשוב, מה יש בו ומי מעדכן אותו. גם “האקסל של יוסי” נכנס לרשימה.
- בוחרים תהליך עסקי אחד. לא מנקים את כל העסק בבת אחת. בוחרים את התהליך שעליו מתוכנן פרויקט ה-AI הראשון, למשל טיפול בלידים, ומתמקדים בנתונים שלו.
- ממנים בעלים לכל מקור. אדם אחד, בשם, שאחראי על נכונות הנתונים ועל ההחלטות לגביהם.
- כותבים הגדרות לשדות המרכזיים. מה נחשב “לקוח פעיל”? מתי עסקה עוברת ל“סגורה”? הגדרה כתובה של שורה אחת חוסכת ויכוחים ושגיאות.
- מנקים פעם אחת לעומק. ממזגים כפילויות, מתקנים פורמטים ומארכבים רשומות מתות.
- מונעים מהבלגן לחזור. הופכים שדות חופשיים לרשימות בחירה, מוסיפים שדות חובה ומגדירים בדיקות תקינות אוטומטיות בזמן ההזנה.
- מודדים באופן שוטף. לוח מחוונים פשוט שמציג אחוזי מילוי של שדות, מספר כפילויות חדשות ומועד העדכון האחרון של כל מקור. כך איכות הנתונים הופכת למשהו שרואים, ולא רק מדברים עליו.
שלב 6 הוא החשוב ביותר לטווח הארוך. ניקוי בלי מניעה מחזיר אתכם לאותה נקודה בתוך כמה חודשים.
רשימת בדיקה: האם הנתונים שלכם מוכנים ל-AI?
עברו על הרשימה יחד עם מי שמכיר את המערכות בעסק. כל סעיף שאתם לא יכולים לסמן הוא משימה שכדאי לטפל בה לפני שמשקיעים בפיתוח.
כפילויות ב-CRM
- בדקתם כמה רשומות כפולות יש לפי טלפון, אימייל או מספר עוסק.
- יש כלל ברור למיזוג רשומות, ומישהו שמבצע אותו.
- המערכת מתריעה או חוסמת כשמנסים ליצור רשומה כפולה.
בעלות ואחריות
- לכל מקור נתונים מרכזי יש בעלים בשם.
- ברור מי מאשר שינוי במבנה, כמו הוספת שדה או שינוי שלבים במשפך המכירות.
הגדרות שדות
- יש מסמך קצר שמגדיר את השדות והסטטוסים המרכזיים.
- שדות קריטיים הם רשימות בחירה ולא טקסט חופשי.
- כל הצוות משתמש באותן הגדרות בפועל, לא רק על הנייר.
עדכניות
- אתם יודעים מתי כל מקור עודכן לאחרונה.
- עסקאות ופניות מתעדכנות בזמן אמת או לפחות מדי יום, ולא בסוף החודש.
- יש תהליך לסגירה או לארכוב של רשומות לא פעילות.
הרשאות גישה
- כל עובד רואה רק את מה שהוא צריך לתפקידו.
- עובדים שעזבו נותקו מכל המערכות.
- נשמרת היסטוריית שינויים, כך שאפשר לדעת מי שינה מה.
פרטיות
- אתם יודעים איזה מידע אישי רגיש אתם מחזיקים, כמו מספרי זהות, מידע רפואי או פרטים פיננסיים.
- הוגדר מה מותר ומה אסור להעביר לכלי AI חיצוניים.
- בדקתם עם יועץ משפטי את החובות שלכם לפי חוק הגנת הפרטיות.
אם את רוב הסעיפים אפשר לסמן, יש לכם בסיס טוב להתחיל. אם לא, זו לא סיבה לוותר על AI, אלא סימן ברור לאן להשקיע קודם.
מה עם פרטיות ואבטחת מידע כשמחברים נתונים ל-AI?
לפני שמחברים נתוני לקוחות לכלי AI, צריך לדעת לאן המידע עובר, מי יכול לגשת אליו והאם הספק משתמש בו לאימון המודלים שלו. זו שאלה עסקית ומשפטית, לא רק טכנית.
בישראל חלים חוק הגנת הפרטיות ותקנות אבטחת המידע שהותקנו מכוחו. תיקון 13 לחוק, שנכנס לתוקף באוגוסט 2025, הרחיב את סמכויות האכיפה של הרשות להגנת הפרטיות. המאמר הזה אינו ייעוץ משפטי, ובכל מקרה של ספק כדאי להתייעץ עם עורך דין שמתמחה בתחום.
מבחינה מעשית, כמה כללים עוזרים:
- מצמצמים. מעבירים למערכת ה-AI רק את השדות שהיא באמת צריכה. סוכן שמתאם פגישות לא צריך מספר תעודת זהות.
- בודקים את תנאי הספק. בתוכניות העסקיות של ספקי AI גדולים בדרך כלל אפשר לוודא שהמידע לא משמש לאימון. בגרסאות החינמיות זה לא תמיד המצב.
- שוקלים סביבה מבודדת. כשמדובר במידע רגיש במיוחד, אפשר להריץ מודל שפה על שרת פרטי, כך שהנתונים לא יוצאים מהארגון.
- מתעדים. רושמים אילו נתונים מחוברים לאילו מערכות, כדי שתוכלו לענות על השאלה הזו כשתישאל.
האם צריך לחכות לנתונים מושלמים לפני שמתחילים?
לא. נתונים מושלמים לא קיימים, והמתנה להם היא דרך מנומסת לא להתחיל. המטרה היא נתונים טובים מספיק לתהליך הספציפי שאתם רוצים לשפר.
הדרך הנכונה היא לעבוד במקביל: לבחור פרויקט AI ראשון ומוגדר, ולסדר בדיוק את הנתונים שהוא צריך. כך הניקוי מקבל מטרה ברורה ומדידה, והפרויקט מקבל בסיס יציב.
לטווח הארוך, ככל שהמערכות שלכם מחוברות יותר, היתרון גדל. איחוד מקורות נתונים, חיבור ה-CRM למערכות התפעול ובניית אינטגרציות נכונות הם הבסיס למערכות ERP דינמיות שמשלבות AI ולאוטומציות שממשיכות לעבוד לאורך זמן. אם אתם רוצים לראות איך נראה תהליך כזה, אפשר לקרוא על תחומי השירות שלנו, כולל בניית תשתית מוכנה ל-AI.
בשורה התחתונה
AI טוב בדיוק כמו הנתונים שמזינים לו. לפני שמשקיעים בסוכנים ובמודלים, כדאי לעבור על רשימת הבדיקה, למנות בעלים לנתונים ולמנוע מהבלגן לחזור. זו עבודה פחות נוצצת, אבל היא זו שקובעת אם פרויקט ה-AI שלכם יגיע לשימוש אמיתי או ייתקע בפיילוט.
שאלות נפוצות
כמה זמן לוקח לסדר את הנתונים לפני פרויקט AI?
זה תלוי במספר מקורות הנתונים ובמצבם. כשמתמקדים בתהליך עסקי אחד, למשל טיפול בלידים, ולא בכל העסק בבת אחת, העבודה ממוקדת ומוגדרת הרבה יותר. מיפוי ראשוני של המקורות עוזר להעריך את ההיקף לפני שמתחילים.
אפשר להשתמש ב-AI כדי לנקות את הנתונים עצמם?
כן, חלקית. כלי AI טובים בזיהוי רשומות דומות, באחידות הכתיב של שמות וכתובות ובסיווג טקסט חופשי לקטגוריות. אבל ההחלטות עצמן, כמו איזו רשומה נשארת ומה ההגדרה הנכונה של סטטוס, צריכות להישאר אצל אדם שמכיר את העסק.
מותר להעלות קובץ לקוחות לכלי AI כמו ChatGPT?
לפני שמעלים מידע אישי של לקוחות לכלי AI כלשהו, בדקו אם הגרסה שבה אתם משתמשים מתחייבת שהמידע לא ישמש לאימון, ומה מדיניות שמירת המידע שלה. העבירו רק את השדות ההכרחיים, ובגלל החובות לפי חוק הגנת הפרטיות, קבלו הנחיה מיועץ משפטי למקרה שלכם.
מי בעסק צריך להיות אחראי על איכות הנתונים?
לא בהכרח איש IT. עדיף מי שעובד עם הנתונים ביום-יום ומבין את המשמעות שלהם, למשל מנהלת המכירות לגבי נתוני ה-CRM. העיקר שזה יהיה אדם אחד בשם, עם זמן מוגדר למשימה.
מאמרים קשורים
למה 80% מפרויקטי AI נכשלים, ואיך להימנע מזה
למה פרויקטי AI נכשלים בעסקים? הסיבות האמיתיות שמאחורי הכישלון, סימני האזהרה המוקדמים ותוכנית עבודה מעשית שמגדילה את סיכויי ההצלחה של הטמעת AI.
העתיד של ה-ERP: שכבת AI סביב המערכת הקיימת
איך מוסיפים AI ואוטומציה למערכת ERP קיימת כמו פריוריטי או SAP Business One בלי להחליף אותה: מבנה השכבה, משימות מתאימות ודרך בטוחה להתחיל.